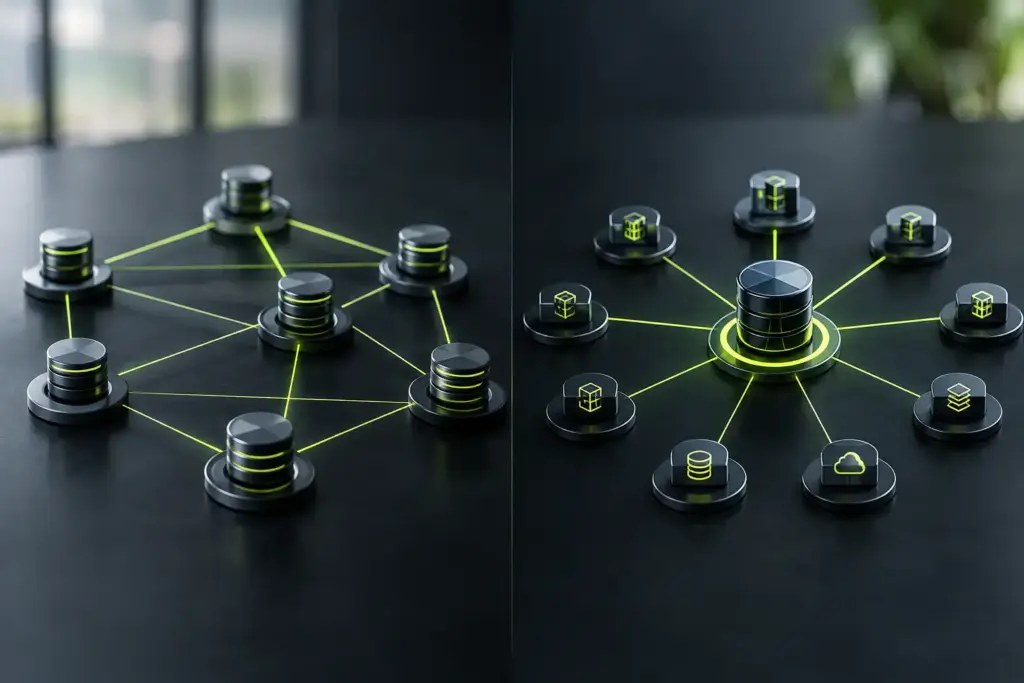
Wenn Fachbereiche eigene Datenprodukte aufbauen wollen, während zentrale Teams zugleich Governance, Sicherheit und Kosten im Griff behalten müssen, wird die Frage nach Data Mesh versus Data Fabric konkret. Es geht nicht um zwei austauschbare Architekturbegriffe. Beide Ansätze setzen an unterschiedlichen Engpässen an: Data Mesh vor allem an Organisation, Verantwortung und Wertschöpfung. Data Fabric vor allem an Integration, Automatisierung und technischer Vernetzung.
Die falsche Frage lautet deshalb: Welcher Ansatz ist moderner? Die bessere lautet: Welches Problem bremst deine Datennutzung derzeit tatsächlich – fehlende Ownership in den Domänen, technische Datensilos, unklare Begriffe und Zugriffe oder eine Kombination daraus?
Data Mesh: Daten als Produkt und Verantwortung der Domäne
Data Mesh beschreibt ein soziotechnisches Modell für den Umgang mit Daten in großen, komplexen Organisationen. Es fordert, Datenverantwortung näher an die Fachdomänen zu verlagern. Das Team, das etwa Aufträge, Lieferkettenereignisse oder Produktionsdaten verantwortet, soll die zugehörigen Daten nicht nur erzeugen, sondern als nutzbares Datenprodukt bereitstellen.
Ein Datenprodukt ist mehr als ein Export aus einem Quellsystem. Es braucht einen klaren Zweck, definierte Nutzer, fachliche Metadaten, dokumentierte Qualitätsmerkmale, Zugriffsschnittstellen und einen verantwortlichen Owner. Für andere Teams muss nachvollziehbar sein, was ein Feld bedeutet, wie aktuell die Daten sind, welche Einschränkungen gelten und unter welchen Bedingungen sie verwendet werden dürfen.
Das ist attraktiv, weil zentrale Datenplattformteams in vielen Unternehmen zum Engpass werden. Sie sollen jede neue Datenquelle anbinden, jedes Reporting-Modell abstimmen, Zugriffsfragen lösen und Qualitätsprobleme auffangen. Ein Mesh verteilt diese Verantwortung. Doch Dezentralisierung funktioniert nicht durch eine neue Organisationsgrafik. Sie funktioniert nur, wenn Domänenteams Zeit, Fähigkeiten und verbindliche Standards erhalten.
Die vier Ebenen, die ein Mesh tragen müssen
Im Kern verlangt ein Data Mesh domänenorientierte Ownership, Daten als Produkt, eine Self-Service-Datenplattform und föderierte Governance. Gerade der letzte Punkt wird häufig unterschätzt. Föderiert heißt nicht, dass jede Domäne ihre Regeln selbst erfindet. Datenschutzklassifizierung, Identitäts- und Berechtigungskonzepte, Aufbewahrung, Auditierbarkeit, Mindestmetadaten und Interoperabilitätsstandards müssen organisationsweit gelten.
Die zentrale Plattform stellt dafür wiederverwendbare Fähigkeiten bereit: Bereitstellung, Katalogisierung, Observability, Policy Enforcement, Datenvertragsprüfung und gegebenenfalls sichere Austauschmechanismen. Die Domäne verantwortet dagegen Bedeutung, Qualität und Weiterentwicklung ihres Datenprodukts. Diese Trennung ist anspruchsvoll, aber produktiv: Zentralisierung bleibt dort sinnvoll, wo Skaleneffekte und verbindliche Kontrollen zählen. Fachliche Verantwortung bleibt dort, wo das Wissen entsteht.
Data Fabric: Vernetzung durch Metadaten und Automatisierung
Eine Data Fabric ist keine feste Referenzarchitektur und kein einzelnes Produkt. Der Begriff bezeichnet vielmehr einen Architekturansatz, der Daten über verteilte Systeme hinweg auffindbar, integrierbar, steuerbar und nutzbar machen soll. Im Zentrum stehen Metadaten und deren aktive Nutzung: technische Metadaten aus Pipelines und Schemata, fachliche Definitionen, Klassifikationen, Nutzungsinformationen, Datenherkunft und Richtlinien.
Eine Fabric versucht, aus diesen Informationen operative Fähigkeiten abzuleiten. Dazu gehören etwa die Erkennung sensibler Daten, Vorschläge für Datenzuordnungen, Nachverfolgung der Lineage, konsistente Zugriffskontrollen oder die Überwachung von Datenqualität. Der Anspruch ist, die Reibung zwischen Datenbanken, SaaS-Anwendungen, Streaming-Plattformen, Data Lakes, Warehouses und operativen Systemen zu senken.
Damit adressiert die Fabric ein reales Problem: Selbst gut organisierte Teams scheitern, wenn niemand weiß, welche Daten bereits existieren, welche Kennzahl verbindlich ist oder welche Downstream-Prozesse ein Schema-Update gefährdet. Ein Katalog allein löst das nicht. Entscheidend ist, ob Metadaten aktuell bleiben und ob sie in Entwicklungs-, Betriebs- und Governance-Prozesse eingebunden sind.
Was eine Fabric nicht automatisch leistet
Technische Vernetzung ersetzt keine fachliche Einigung. Wenn Vertrieb, Finance und Operations unterschiedliche Definitionen von Umsatz verwenden, kann eine Fabric die Unterschiede sichtbar machen und Regeln durchsetzen. Sie kann aber nicht entscheiden, welche Definition für welchen Steuerungszweck gilt. Das ist eine Governance- und Führungsaufgabe.
Auch Datenqualität entsteht nicht durch automatisierte Profiling-Regeln allein. Sie können fehlende Werte, unerwartete Verteilungen oder Schemaabweichungen erkennen. Ob ein Lieferstatus fachlich plausibel ist oder eine Preislogik korrekt angewendet wurde, wissen meist die verantwortlichen Domänen. Wer eine Fabric als Lösung für jedes Datenproblem einkauft, verlagert diese offenen Fragen nur in ein neues Toolset.
Data Mesh versus Data Fabric: Der entscheidende Unterschied
Der Unterschied liegt in der primären Perspektive. Data Mesh verändert das Betriebs- und Verantwortungsmodell für Daten. Data Fabric beschreibt Fähigkeiten, mit denen Datenlandschaften technisch verbunden und steuerbar werden. Das eine ist also vor allem ein Organisations- und Governance-Modell, das andere ein Architektur- und Automatisierungsansatz.
Diese Unterscheidung verhindert zwei typische Fehlentscheidungen. Erstens: Ein Unternehmen führt einen Datenkatalog, eine Integrationsplattform und Policy-Werkzeuge ein und nennt das Data Mesh. Ohne echte Ownership in den Domänen bleibt es eine zentral betriebene Datenplattform mit besserer Technik. Zweitens: Ein Unternehmen dezentralisiert Verantwortung, ohne gemeinsame Standards und Plattformfähigkeiten aufzubauen. Dann entstehen nicht Datenprodukte, sondern neue Silos mit besseren Namen.
In der Praxis schließen sich Mesh und Fabric daher nicht aus. Eine Data Fabric kann technische Bausteine liefern, die ein Mesh braucht: Metadatenmanagement, Lineage, Zugriffskontrolle, Discovery und Observability. Umgekehrt gibt ein Mesh der Fabric eine klare fachliche Struktur. Metadaten werden wertvoller, wenn eindeutig ist, wer ein Datenprodukt verantwortet und welche Erwartungen daran gelten.
Welche Ausgangslage spricht wofür?
Wenn dein vorrangiges Problem heterogene Datenquellen, unklare Datenherkunft, manuelle Zugriffsprozesse oder schwer auffindbare Datenbestände sind, liegt der erste Hebel oft bei Fabric-Fähigkeiten. Baue ein belastbares Metadatenfundament auf, vereinheitliche Identitäten und Policies und mache Datenflüsse beobachtbar. Das kann auch in einer weitgehend zentralen Organisation sinnvoll sein.
Wenn dagegen zentrale Teams chronisch fachliche Rückfragen abarbeiten, wichtige Datensätze keine klaren Eigentümer haben oder Domänen zu lange auf zentrale Umsetzung warten, ist die Mesh-Perspektive relevanter. Starte dann nicht mit einer unternehmensweiten Reorganisation. Wähle zwei oder drei Domänen mit klarer Wertschöpfung, handlungsfähigen Verantwortlichen und wiederkehrenden Datenkonsumenten.
Ein hybrider Ansatz ist häufig plausibel, aber kein Selbstläufer. Zentral geführte Kontrollfunktionen bleiben besonders bei personenbezogenen Daten, kritischen Infrastrukturen, Finanzdaten oder regulatorisch relevanten Nachweisen notwendig. Föderation bedeutet nicht, Sicherheits- und Compliance-Entscheidungen zu verteilen, ohne Verantwortlichkeiten und Kontrollpunkte präzise festzulegen.
Die Architekturfrage beginnt vor dem Tooling
Bevor du Plattformen vergleichst, solltest du einige Architekturentscheidungen schriftlich festhalten. Was gilt in deinem Unternehmen als Datenprodukt? Welche Mindestinformationen müssen vorliegen, damit andere Teams es nutzen dürfen? Wie werden Datenverträge zwischen Produzenten und Konsumenten versioniert? Wer darf Klassifikationen ändern, Zugriffe freigeben und Ausnahmen genehmigen?
Ebenso wichtig ist der Betriebsblick. Datenpipelines benötigen Monitoring, Incident-Prozesse, Service-Level-Ziele und nachvollziehbare Changes. Wenn ein Datenprodukt in einem Risiko-Reporting ausfällt, darf die Verantwortung nicht zwischen Fachbereich, Plattformteam und Analytics-Team verschwimmen. Data Observability ist deshalb kein nachgelagertes Komfortthema, sondern Teil der Produktionsreife.
Auch Kosten verdienen Aufmerksamkeit. Eine Fabric kann Datenbewegungen und Abfragen über mehrere Plattformen hinweg vereinfachen, aber zusätzliche Kopien, Egress-Kosten und komplexe Abrechnungsmodelle erzeugen. Ein Mesh kann lokale Entscheidungsfähigkeit erhöhen, aber Plattformstandards und Enablement erfordern dauerhafte Investitionen. Rechne deshalb nicht nur Lizenzen, sondern auch Betriebsaufwand, Qualifizierung, Governance und Migrationsrisiken.
Mit einem überprüfbaren Anwendungsfall starten
Ein guter Einstieg verbindet eine fachlich relevante Entscheidung mit klaren technischen Grenzen. Denkbar ist etwa ein bereichsübergreifender Prozess, bei dem Daten aus mehreren Domänen benötigt werden und die heutige Bereitstellung zu langsam, fehleranfällig oder intransparent ist. Definiere dafür Produktverantwortung, Qualitätskriterien, Zugriffspfade und Messgrößen, bevor du die Architektur ausrollst.
Entscheidend ist, ehrlich zu messen: Verkürzt sich die Zeit bis zur nutzbaren Datenbereitstellung? Werden Datenfehler früher erkannt? Sinkt der manuelle Abstimmungsaufwand? Können Auditoren Herkunft und Berechtigungen nachvollziehen? Bleiben diese Effekte aus, liegt das selten nur an fehlenden Features. Häufig fehlen klare Verantwortlichkeiten, verbindliche Standards oder die Bereitschaft, alte Schattenprozesse abzulösen.
Die tragfähige Datenarchitektur entsteht nicht dadurch, dass du Data Mesh oder Data Fabric zum Leitbegriff erklärst. Sie entsteht, wenn technische Fähigkeiten, fachliche Verantwortung und Governance im Alltag zusammenpassen. Genau dort lohnt sich die kritische Diskussion – nicht bei der Frage, welches Etikett auf der Zielarchitektur besser aussieht.